
【ICLR 2026 Oral】プロンプト改善は強化学習より速く学べるか?GEPA論文を実務目線で読む
AIエージェントを改善するとき、モデルを追加学習する前に、失敗の理由を文章へ戻したほうが速いかもしれない。
Agrawalらの論文「GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning」が示したのは、その可能性である。GEPAはモデルの重みを変えない。AIシステムの実行履歴、採点結果、コンパイルエラーなどをLLMに読ませ、失敗を減らす指示へプロンプトを書き換える。複数の改善案を競わせ、異なる問題で勝った案を残す。
2026年2月14日に公開されたv2はICLR 2026 Oral採択版で、6タスクの平均ではGRPOを約6ポイント上回り、最大35分の1のロールアウトで最良性能へ到達したと報告している。
ただし、私がこの論文で最も重要だと思ったのは「プロンプトが強化学習に勝った」という見出しではない。1回の失敗を0点で捨てず、どこで、なぜ失敗したかを次の変更へ戻す設計である。
GEPAは何を変えるのか
一般的な強化学習では、ある回答や一連の操作を実行し、最後に得た報酬からモデルの重みを更新する。成功なら1、失敗なら0という評価でも学習できるが、その数字だけでは、検索が悪かったのか、推論が悪かったのか、出力形式だけを間違えたのかが分からない。
GEPAは、モデルの重みではなくAIシステム内のプロンプトを探索する。必要なのは次の4つである。
- 改善対象となる一つ以上のプロンプト
- 入力と正解、または期待結果を持つ訓練データ
- 出力を数値で採点する評価指標
- 失敗理由を文章で返すフィードバック関数
処理は、候補となるプロンプトを選び、小さな入力群でAIシステムを実行し、入出力、推論、道具の呼び出し、評価時のエラーを記録するところから始まる。別のLLMがその履歴を振り返り、対象モジュールの指示を修正する。新しい候補が改善していれば候補群へ加え、予算が尽きるまで繰り返す。
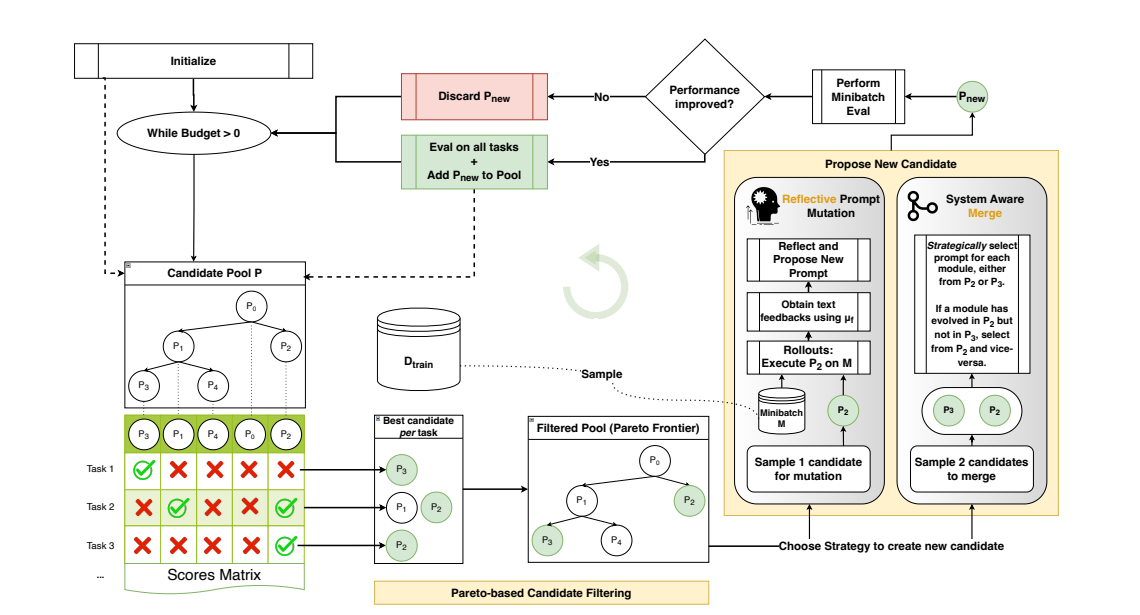
ここで扱うのは、一問一答のプロンプトだけではない。検索、回答生成、検証など複数のLLMモジュールからなるAIシステムでも、実行履歴を見て、どのモジュールへ責任を割り当てるかを文章で判断する。
0点の中に残っている情報を使う
この論文の核は、自然言語を学習信号として使う点にある。
たとえば生成コードがコンパイルに失敗した場合、報酬は0でも、コンパイラは行番号や型の不一致を返す。指示追従タスクなら、採点器は「引用符がない」「末尾の定型文が抜けた」と説明できる。検索型QAなら、取得した文書と回答のどこが結び付いていないかを追える。
GEPAは、この文章を現在のプロンプトと実行履歴へ添えて、次の指示案を作る。数値だけを使うより、少ない試行で大きく挙動を変えられる理由はここにある。
私の理解では、GEPAはプロンプト最適化の論文であると同時に、観測可能性の論文でもある。失敗時に「失敗しました」しか残らないシステムでは、反省する材料がない。入力、途中出力、道具の結果、評価根拠を追えるシステムほど改善しやすい。
これは、以前まとめたAIエージェントのトレース設計と同じ問題につながる。ログは障害調査のためだけにあるのではない。次の設計を学ぶためのデータでもある。
なぜ一番良い候補だけを残さないのか
GEPAのもう一つの特徴は、候補の選び方にPareto frontierを使うことである。
平均点が最も高い案だけを残すと、全体では強いが、特定の問題群だけを繰り返し落とすプロンプトへ収束しやすい。そこでGEPAは、訓練例ごとに最高得点を記録し、少なくとも一部の例で勝っていて、ほかの候補に完全には支配されない案を残す。
たとえば候補Aは複数文書の検索に強く、候補Bは厳密な出力形式に強いかもしれない。総合点だけならAを残してBを捨てるところを、GEPAは両方を探索対象にする。論文では、現在の最高候補だけを選ぶ方法やビームサーチより、Pareto方式が全ベンチマークの集計でそれぞれ6.4ポイント、7.33ポイント高かった。
この設計は実務でも重要である。平均正答率だけを見ると、少数の難しい顧客、長い文書、特定の言語、例外的な入力の失敗が隠れる。評価データセットを通常例、境界例、失敗再現例に分けるのは、それぞれで勝つ候補を見失わないためでもある。
実験結果をどう読むか
論文は、HotpotQA、IFBench、HoVer、PUPA、AIME-2025、LiveBench-Mathの6タスクを使い、Qwen3 8BとGPT-4.1 Miniで評価した。比較対象はGRPO、MIPROv2、TextGrad、Traceなどである。
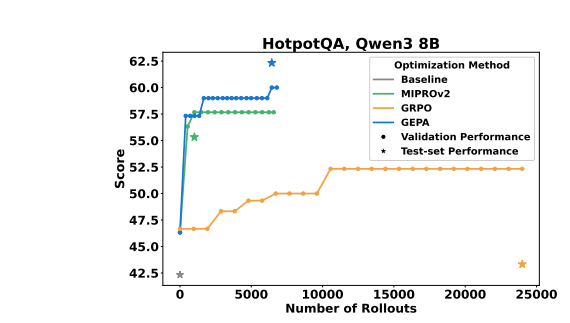
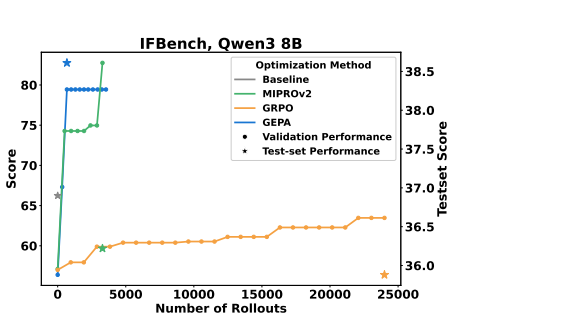
Qwen3 8Bの6タスク平均は次のようになった。
| 方法 | 平均スコア | ベースラインからの改善 | 最適化時のロールアウト数 |
|---|---|---|---|
| ベースライン | 45.23 | 0 | なし |
| GRPO | 48.91 | +3.68 | 各タスク24,000 |
| MIPROv2 | 47.84 | +2.61 | タスクごとに異なる |
| GEPA | 54.85 | +9.62 | 平均3,936 |
GEPAは6タスク中5タスクでGRPOを上回り、最良のテスト性能へ4倍から35倍少ないロールアウトで到達した。IFBenchでは678回のロールアウトで38.61%に達し、24,000回使ったGRPOの35.88%を上回っている。
一方、すべてに勝ったわけではない。Qwen3 8BのAIME-2025ではGRPOが38.00%、GEPAは32.00%だった。タイトルの「Can Outperform」は「条件によって上回り得る」であり、重みの学習が不要になったという結論ではない。
また、Qwen3 8Bで最適化したプロンプトをそのままGPT-4.1 Miniへ移すと、6タスク平均で9ポイント改善した。対象モデル上で直接最適化した比較手法より高かったという結果は面白い。GEPAがモデル固有の癖だけでなく、タスクを解くための比較的抽象的な規則を学んだ可能性がある。
実務では、評価関数が製品仕様になる
研究から事業会社のデータサイエンスへ移ってきた立場で読むと、GEPAを導入する難所は最適化アルゴリズムではない。失敗を説明できる評価関数を作ることである。
数式問題やコード生成は、正解、テスト結果、コンパイラの出力を得やすい。しかし、問い合わせ対応、企画書、社内検索では「良い回答」の境界が曖昧になる。利用者が満足したかは後から分かり、売上や解約への影響には別の要因も混ざる。
評価器が誤っていれば、GEPAはその誤りへ忠実に最適化する。丁寧さを文字数で測れば長文になり、出典数を評価すれば不要な引用を増やす。平均点だけなら、重要だが件数の少ない安全上の失敗を切り捨てる可能性もある。
したがって本番で先に作るべきなのは、万能な反省プロンプトではない。
- 成功と失敗を判定できる小さな仕事単位
- 正しさ、形式、安全性、費用を分けた評価項目
- 不合格理由を具体的に返す採点器
- 改善用データと最終確認用データの分離
- プロンプト変更を戻せる版管理
プロンプトは文章だが、運用上はコードと同じ変更物である。モデル、プロンプト、道具を一つの実行構成として版管理する必要がある。GEPAが生成した候補も、差分、評価値、使用データ、実行費用を残し、段階的に本番へ出すべきだ。
少ないロールアウトと、安い運用は同じではない
最大35分の1という数字は強い。ただし、ロールアウト回数だけで費用を判断できない。
GEPAは各試行で、対象システムの実行に加えて、履歴を読むreflection LMも呼び出す。候補をPareto用データへ再評価する処理もある。GRPOは学習計算と重みの配備が必要で、GEPAは長い文脈と複数のAPI呼び出しが必要になる。両者の1ロールアウト当たり費用は同じではない。
一方、最適化後の運用費には利点がある。論文の追加分析では、GEPAが作ったプロンプトはMIPROv2より約33%短く、性能は高かった。少数の明示的な規則へ圧縮できれば、毎回多くのfew-shot例を渡す方式より推論費用を抑えやすい。
本番では、最適化中のモデル費、道具の呼び出し、評価時間、人による確認、最終プロンプトの入力トークンを同じ単位へ直す必要がある。一つの利用者操作にかかった総費用を追う考え方が、そのままGEPAにも当てはまる。
自動改善は、自動攻撃にもなる
論文はGEPAを逆向きに使う実験も行っている。性能を上げるのではなく、タスクの説明を保ったまま、成績を落とすプロンプトを探索した。
その結果、GPT-5 MiniのAIME-2025におけるpass@1は、通常プロンプトの76%から10%まで低下した。無関係な豆知識などを指示へ混ぜ、推論を乱す候補を自動で発見したためである。
これは付録的な結果ではあるが、実務上は見逃せない。評価できる対象は最適化できる。目的関数を反転すれば、攻撃プロンプトも自動探索できる。
自動プロンプト改善の実行環境には、訓練データと本番データの分離、使える道具の制限、外部送信の禁止、候補プロンプトのレビュー、予算上限が必要になる。AIエージェントのガードレールを、最適化する側にも適用しなければならない。
この論文から持ち帰るもの
GEPAは、プロンプトを人の勘で少しずつ直す作業を、評価データ、実行履歴、文章による失敗理由、候補探索へ分解した。ここに価値がある。
強化学習と比べて少ない試行で性能が上がったのは、言語モデルが自分の履歴を読めるからである。しかし、その利点が出るのは、履歴に原因が残り、評価器が間違いを説明し、訓練例が本番の失敗を代表している場合に限られる。
私なら、いきなり全社のAIエージェントを自己改善させない。まず、正解と失敗理由を比較的はっきり書ける一つの工程を選ぶ。候補プロンプトを自動生成しても、本番への採用は評価用データと人の確認を通す。そこで改善が再現するなら、次のモジュールへ広げる。
GEPAが教えているのは、プロンプトが魔法になったことではない。良い評価と詳しい失敗記録があれば、AIシステムは少ない試行から多くを学べるということだ。逆に言えば、何を成功と呼ぶかを決められない仕事は、自動改善もできない。